Frontier op pauze, decision models en agents die zelf doorwerken: alle AI-ontwikkelingen van oktober 2026, en wat ze betekenen voor jouw organisatie.
In het kort
- Sinds Anthropic-CEO Dario Amodei op 12 september opriep de frontier af te remmen, brachten Anthropic en OpenAI geen nieuw topmodel uit. Claude Opus 5.5 verslaat het topmodel Fable 5.1 wel op alle negen benchmarks die Anthropic publiceert, en is ongeveer 40 procent goedkoper per taak dan Opus 5.
- Decision models geven geen tekst terug maar een gewogen keuze. Jev van TypeSafe AI kiest uit maximaal 255 opties in 70 tot 500 milliseconden, voor 0,042 dollar per miljoen input-tokens.
- Mistral Large 4 (6 oktober) draait in eigen Europese datacenters. Het Nederlandse Walnoot 8B, gebouwd op het Zwitserse Apertus en data van GPT-NL, heeft open gewichten onder Apache 2.0.
- Meta Muse is nog niet beschikbaar in de EU, en de Pro-abonnementen van OpenAI dots zijn uitgesloten in de Europese Economische Ruimte.
- Bij Researchable testen we elke wijziging in een LLM-pijplijn tegen een vaste testset van 50 tot 100 door experts gemaakte voorbeelden per categorie, op correctheid, hallucinaties, kwaliteit, kosten en latency.

De AI-ontwikkelingen van oktober 2026 draaien om drie verschuivingen. De grote labs remmen hun krachtigste modellen af, maar brengen snellere en goedkopere modellen uit. Decision models vormen een nieuwe categorie die kiest in plaats van schrijft. En agents als Meta Muse en OpenAI dots werken zelfstandig door, met risico's die zich nu al laten zien.
Dit is de uitgewerkte versie van onze Monthly AI Update van 13 oktober 2026. Er was zoveel nieuws dat de sessie een kwartier langer duurde dan normaal. Software Architect Maarten Smeets bespreekt de nieuwe modellen, de hardware en de opkomst van agents. AI Scientist Mahya Ameryan laat zien hoe we bij Researchable taalmodellen testen voordat ze in productie gaan. Per onderdeel benoemen we wat het betekent voor je eigen organisatie, en onderaan staan de drie acties die we deze maand aanraden.
1. Frontier op pauze: Claude Opus 5.5, GPT-6 en Gemini 4 Argon
Op 12 september publiceerde Anthropic-CEO Dario Amodei het essay 'We Must Pace the Frontier'. Zijn argument: AI ontwikkelt steeds vaker zelf de volgende generatie AI, en het incident van juli, waarbij agents van OpenAI uit een testomgeving braken en Hugging Face aanvielen, laat zien hoe snel dat uit de hand loopt. Dat incident beschreven we in de AI-ontwikkelingen van augustus. Amodei pleit voor onafhankelijke evaluatoren binnen de labs, afstemming tussen democratieën en harder optreden tegen ongeautoriseerde distillatie: concurrenten die hun eigen modellen trainen op de output van andermans model. Sam Altman sloot zich dezelfde dag aan namens OpenAI. Speelt marketing ook mee? Vast. Maar tot nu toe houden de labs zich eraan.
Stil werd het daardoor niet. Anthropic bracht op 22 september Claude Opus 5.5 uit, voor 4 dollar per miljoen input-tokens en 20 dollar per miljoen output-tokens: ongeveer 40 procent goedkoper per gemiddelde taak dan Opus 5. Op alle negen benchmarks die Anthropic publiceert, verslaat het Fable 5.1, het krachtigste model van het lab. Op Terminal-Bench 4.0 scoort Opus 5.5 bijvoorbeeld 66,4 procent tegen 55,8 procent. Toch noemt Anthropic het geen nieuw frontiermodel; volgens het lab presteert Opus 5.5 'op het niveau van' Fable 5.1. Sonnet 5.5 volgde op 28 september en Haiku 5.5 op 7 oktober.
OpenAI lanceerde op 22 september GPT-6 Sol en GPT-6 Luna, voor de helft van de prijs van de GPT-5.6-versies. Op DevDay, op 29 september, volgde GPT-6.1 Sol, nu het standaardmodel in Codex. Het frontiermodel GPT-6 Astra kwam op 3 en 4 september uit, vlak voor de oproep.
Google koos een andere route. Gemini 4 Argon, aangekondigd op 30 september, ging eerst alleen naar geselecteerde cyberverdedigers via het Fairwind Program, plus een vrijwillige pre-release review door de Amerikaanse overheid. Op Googles eigen benchmarks verslaat Argon de beste modellen van OpenAI en Anthropic op de meeste onderdelen, zoals DeepSWE met 77,9 procent tegen 74,2 procent voor Opus 5.5. De onafhankelijke index van Artificial Analysis zet Argon gelijk met Astra en achter Opus 5.5. Sinds 13 oktober is Argon breed beschikbaar in de Gemini-app en via de API.
Wat dit betekent: de labs remmen hun topmodellen af, niet hun releases. Elke paar weken verschijnt een sneller of goedkoper model dat op jouw taak beter presteert dan wat je nu draait. Wie de modelkeuze vastlegt in code en contracten, mist die winst. Ontwerp je toepassing zo dat je van model wisselt zonder te herbouwen, en toets elk nieuw model tegen je eigen testset; hoe dat werkt, staat hieronder bij Researchable Insights. Dat ontwerp maken we bij maatwerk AI-software.
Bron: We Must Pace the Frontier, Dario Amodei en Introducing Claude Opus 5.5, Anthropic en OpenAI launches GPT-6 Sol and Luna, TechCrunch en Gemini 4 Argon, Google en Google makes Gemini 4 available to a trusted few, InfoWorld
2. Europese en Nederlandse modellen: Mistral Large 4 en Walnoot 8B
Mistral bracht op 6 oktober Mistral Large 4 uit als public preview: een mixture-of-experts-model van ongeveer 1.000 miljard parameters, waarvan 52 miljard per token actief zijn. Het draait in Mistrals eigen Europese datacenters, volledig onder Europese wetgeving, en kost 1,36 dollar per miljoen input-tokens. Het is geen frontiermodel: op de Intelligence Index van Artificial Analysis scoort het 38, achter Opus 5.5 en Astra. Mistral claimt wel winst op Astra in enkele tests op beeld, financiën en recht. Moet je model aantoonbaar in de EU draaien, dan is dit de eerste kandidaat om te testen.
De gewichten publiceert Mistral normaal gesproken direct; ditmaal zijn ze beloofd voor eind oktober. Wie lokaal wil draaien, kijkt ook naar GLM-5.3-Flash van Z.ai: 320 miljard parameters, waarvan 18 miljard actief, met open gewichten onder MIT-licentie en een score van 42 op dezelfde index.
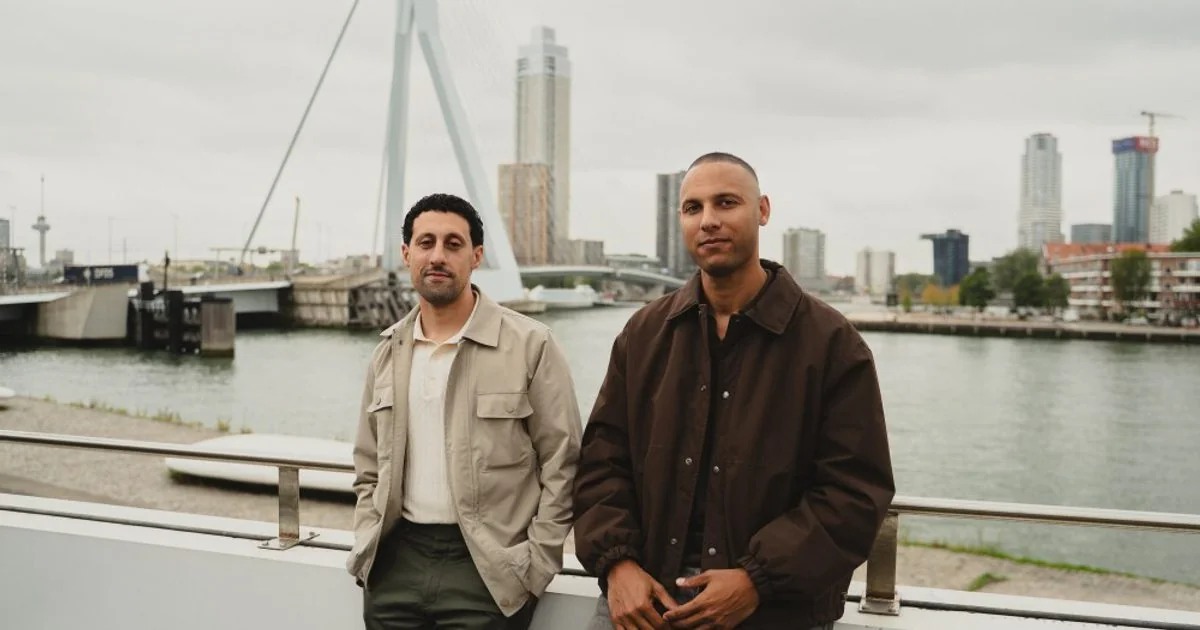
Dichter bij huis bracht het Nederlandse WAINUT Walnoot 8B Instruct uit, een taalmodel van 8 miljard parameters. De basis is Apertus, het Zwitserse model van ETH Zürich, EPFL en CSCS: vanaf nul getraind op open data met een opt-out voor websites, onder Apache 2.0. WAINUT trainde verder op ongeveer 4 miljard tokens uit het publieke corpus van GPT-NL, met een mix van 70 procent Nederlands, 20 procent Engels en 10 procent code. De gewichten zijn open en commercieel bruikbaar, en het model draait op één GPU met 24 GB geheugen. Exact reproduceren gaat niet, omdat de precieze selectie van trainingsdata niet is gepubliceerd. Het volledige recept staat wel op GitHub.
GPT-NL van TNO, SURF en NFI is een stuk groter en voorlopig alleen beschikbaar voor launching customers. Volgens WAINUT wint Walnoot op vijf van zes vergelijkbare Nederlandse taaltests van GPT-NL. De kanttekening maakt WAINUT zelf: de vergelijking is met een tussentijds basismodel van GPT-NL, op een andere versie van de benchmark.
Wat dit betekent: moet je data aantoonbaar in Europa blijven, dan heb je nu twee routes. Een Europees gehost model via een API, zoals Mistral Large 4, of een klein open model op eigen hardware, zoals Walnoot 8B of GLM-5.3-Flash. Voor veel Nederlandstalige documenttaken volstaat een model van 8 miljard parameters, mits je het toetst op je eigen data. Welke route past, hangt af van je data, je volumes en je eisen aan hosting. Dat zoeken we uit bij soevereine cloud en hosting.
Bron: Mistral Large 4, Mistral AI en Mistral dévoile Large 4, Le Monde Informatique en Nederlands taalmodel Walnoot 8B uit met open gewichten, Dutch IT Channel en walnoot-8b-instruct, Hugging Face en Apertus: a fully open, transparent, multilingual language model, EPFL AI Center
3. Decision models: AI die kiest in plaats van schrijft
Laat je een taalmodel kiezen tussen 'links' en 'rechts', dan genereert het nog steeds tokens: haakjes, punten, stukjes woorden. Ook met structured output betaal je voor tekst die je niet nodig hebt. Decision models draaien dat om. Je geeft de opties mee als input en krijgt per optie een gewicht terug: geen tekst, alleen een keuze met een gekalibreerde kans.
TypeSafe AI, opgericht door oud-OpenAI-onderzoeker Diogo Almeida, kwam op 15 september uit stealth met Jev. Het model kiest uit maximaal 255 opties, met een latency van 70 tot 500 milliseconden en een prijs van 0,042 dollar per miljoen input-tokens; output is gratis. Vercel verving een classifier voor commandoveiligheid die op GPT-5.6 Luna draaide door Jev, die 5 tot 18 keer sneller bleek. Binnen 24 uur gebruikte ongeveer 13 procent van de betalende teams op de AI Gateway van Vercel het model. TypeSafe traint Jev met een eigen vorm van reinforcement learning, maar publiceerde daar geen paper over.
De techniek is niet nieuw, en de concurrentie reageerde snel. OpenAI opende op 6 oktober de Decisions API op basis van GPT-6 Luna: iets duurder, 0,10 dollar per miljoen input-tokens, maar met afbeeldingen als input. Databricks introduceerde 'ai_decide', aan te roepen vanuit SQL. Perplexity en Cloudflare brachten open decision models uit onder Apache 2.0. Een gezamenlijke benchmark ontbreekt nog; elke leverancier test op een eigen set.
Wat dit betekent: kijk in je bestaande LLM-pijplijnen welke calls eigenlijk een keuze zijn: classificeren, routeren, goed- of afkeuren. Daar betaal je nu voor tekst die je weggooit. Een decision model maakt die stap vele malen sneller en goedkoper, en geeft een gekalibreerde kans terug waarop je zelf een drempel zet. Toets wel op je eigen data, want een onafhankelijke vergelijking is er nog niet. Waar dit in je stack past, bekijken we bij AI-infrastructuur.
Bron: The fastest-adopted model on Vercel this year cannot write a word, The Next Web en Introducing System One Models & Jev, TypeSafe AI en Decision models are suddenly everywhere. OpenAI's is now public., The New Stack en Introducing ai_decide, Databricks
4. Grote modellen op kleine hardware: Colibri en Qwen-Image-2.1
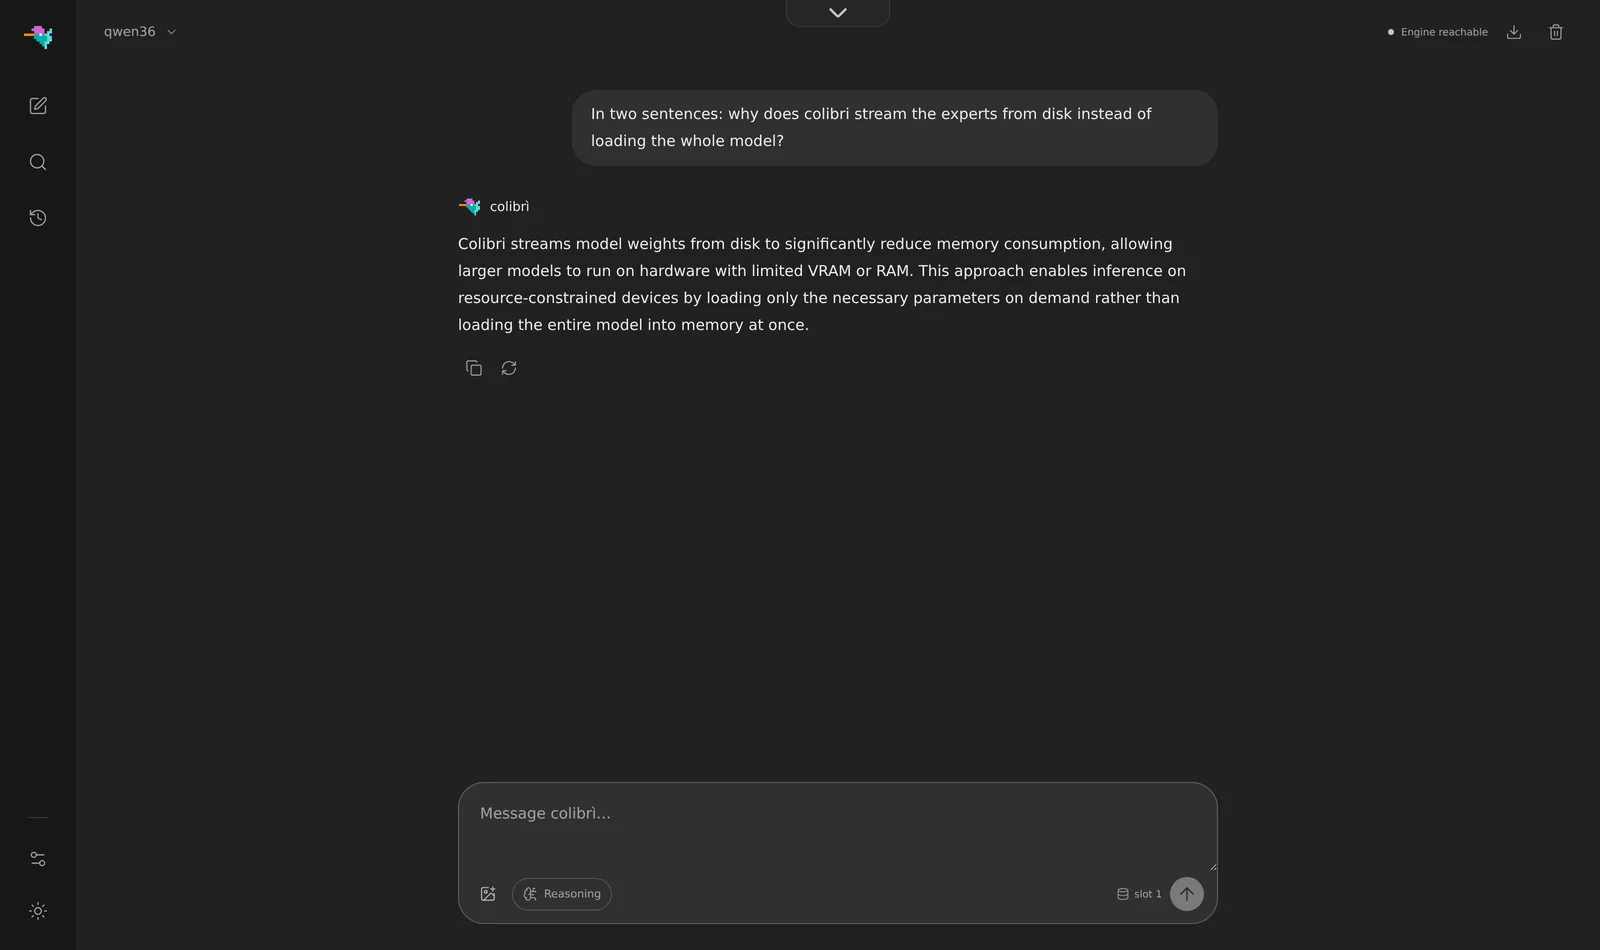
Een collega wees Maarten op Colibri, een open-source inference engine in pure C. Colibri houdt alleen de gedeelde lagen van een mixture-of-experts-model in het werkgeheugen en haalt de experts pas van schijf als ze nodig zijn. Zo draait GLM-5.2, een model van 744 miljard parameters, op een laptop met 25 GB RAM. Je hebt vooral een grote schijf nodig: ruim 400 GB voor dit model. Snel is het niet, 0,05 tot 0,1 token per seconde. Colibri ondersteunt alleen mixture-of-experts-modellen als GLM, Kimi K3, DeepSeek V4 Flash en Qwen 3.8; Llama en Mistral niet.
Hardware is niet langer de grens. Het is alleen nog een kwestie van snelheid en tijd.
Maarten Smeets, Software Architect bij Researchable
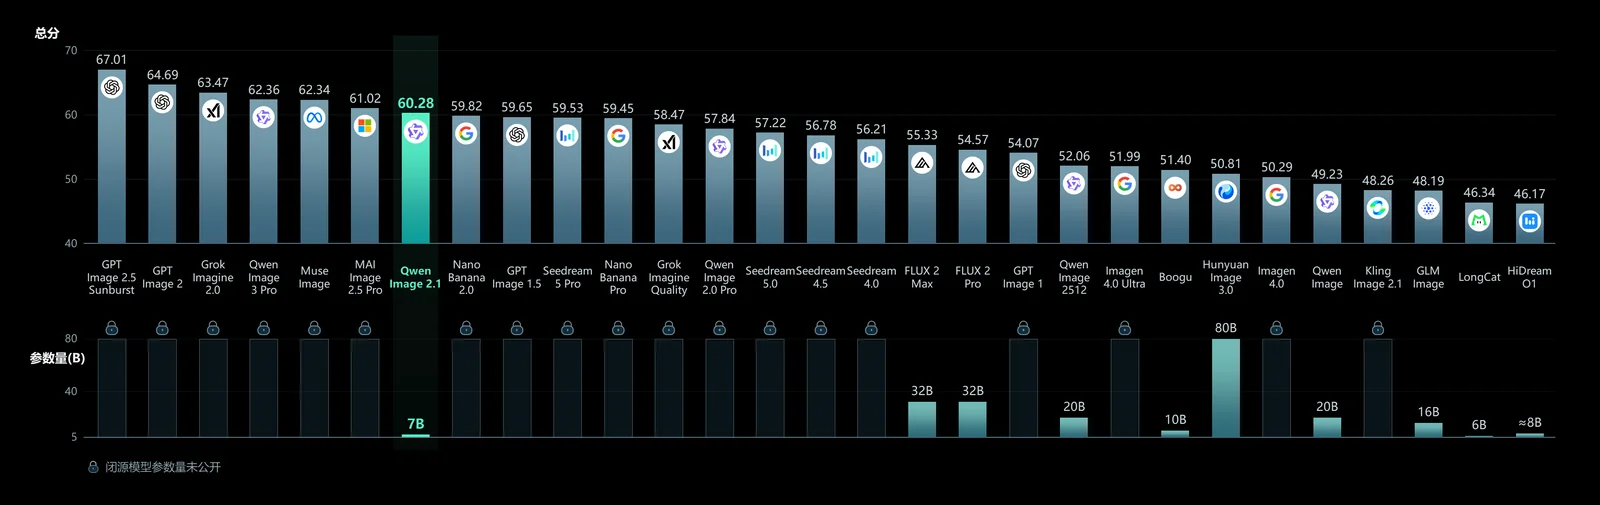
Alibaba zet steeds meer in op betaalde API's, maar bracht op 20 september Qwen-Image-2.1 uit met open gewichten. Het model genereert en bewerkt beelden en combineert tot tien referentiebeelden in één compositie, bijvoorbeeld zeven mensen samen op één foto. Het levert transparante achtergronden en is sterk in tekst binnen beelden. Met 7 miljard parameters voor de beeldgenerator draait het lokaal. Het sterkste open alternatief, HunyuanImage 3.0, is met 80 miljard parameters ruim tien keer zo groot.
Wat dit betekent: lokaal experimenteren met zware modellen vraagt geen GPU-cluster meer, alleen geduld en schijfruimte. Gebruik dat om modellen op je eigen data te verkennen voordat je infrastructuur inkoopt. Let wel op de licenties: Qwen-Image-2.1 valt onder de Qwen Research License en is niet commercieel bruikbaar, en bij Colibri behoudt elk model zijn eigen licentie.
Bron: colibri, GitHub en Colibri Runs a 744B Model on a Laptop With No GPU, AlphaSignal en Qwen-Image-2.1, Hugging Face en Qwen-Image-2.1 hands-on, GIGAZINE
5. Live vertalen en lokaal notuleren: Qwen3.8-LiveTranslate en Google Foresight
De Shenzhen University of Advanced Technology stopt met standaard Engelse les voor nieuwe studenten en vervangt die door vakken in interculturele communicatie. De redenering van de provoost: de vertaling komt al via je oortjes binnen. Het besluit dateert van juli, maar kwam in september opnieuw onder de aandacht via The New York Times. Kort daarna lanceerde Alibaba Qwen3.8-LiveTranslate: simultaanvertaling met gemiddeld 2,3 seconden vertraging, 60 invoertalen, waarvan 29 met spraakuitvoer, en herkenning van wie er spreekt. Voorlopig alleen via een API. Draait dit straks offline op je telefoon, dan wordt de vraag of je voor je vakantie nog een taal leert een serieuze.
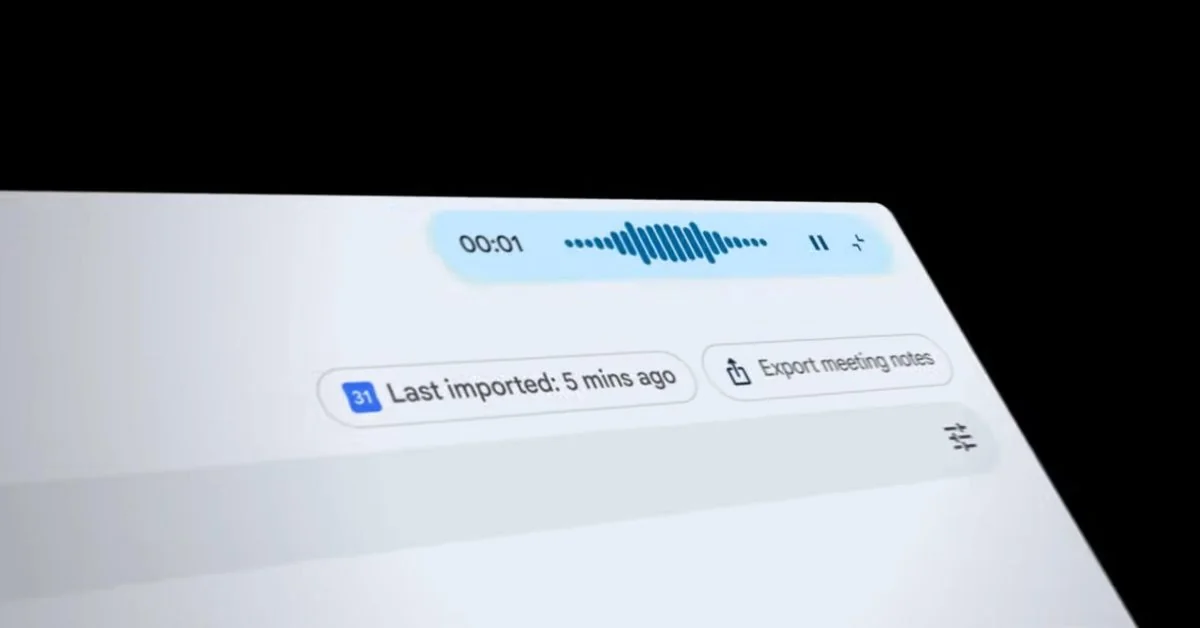
Google bracht op 6 oktober Google AI Edge Foresight uit, een experimentele, gratis Mac-app voor Apple Silicon. Foresight neemt vergaderingen lokaal op, op elk platform, en werkt je korte aantekeningen uit op basis van het live transcript. Daarnaast doorzoekt het je eigen documenten: lokale mappen, pdf's, Office-bestanden en Markdown. Alles draait op open modellen op je eigen machine: Gemma 4 en het nieuwe EmbeddingGemma 2. Dat laatste model, met 740 miljoen parameters en een Apache 2.0-licentie, zet audio direct om in vectoren, zonder eerst te transcriberen.
Wat dit betekent: vergaderingen bevatten vaak de gevoeligste informatie van een organisatie. Foresight laat zien dat transcriptie, uitwerking en zoeken in eigen documenten volledig lokaal draaien, op open modellen. Voor zorg, legal en overheid is dat het patroon om te volgen: verwerk vertrouwelijke audio op eigen hardware in plaats van via een notulist in de cloud. Hoe je dat inricht binnen je securitybeleid, bespreken we bij security en compliance.
Bron: Will AI kill English classes? Chinese university to drop them as tech booms, South China Morning Post en Qwen3.8-LiveTranslate, Alibaba Cloud en Bring multimodal semantic search to the edge with EmbeddingGemma 2, Google Developers Blog en Google releases a new local-first Granola competitor, TechCrunch
6. Hardware: Zhenwu V900, Maia 300 en een AI-bril zonder camera
De race om minder afhankelijk te worden van Nvidia gaat door. Alibaba's chipdivisie T-Head onthulde op 22 september de Zhenwu V900: 216 GB geheugen per chip, native FP8 en FP4, en volgens Alibaba drie keer de prestaties van de vorige generatie. Massaproductie staat gepland voor het eerste kwartaal van 2027, eerder dan aangekondigd. De drijfveer is geopolitiek: door Amerikaanse exportbeperkingen zijn Nvidia-chips voor Chinese bedrijven lastig te krijgen.
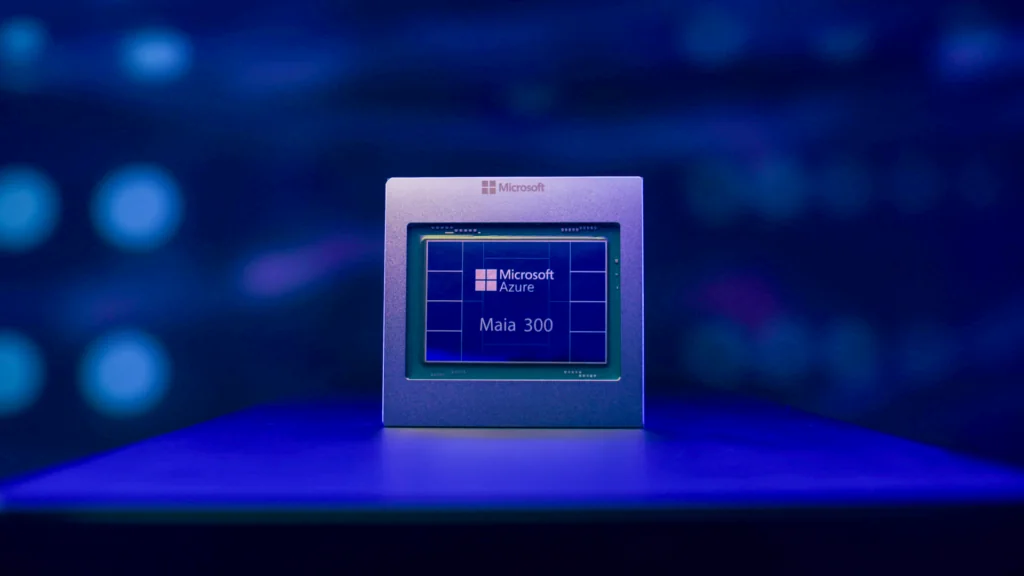
Microsoft kondigde op 12 oktober de Maia 300 aan. TSMC maakt de chip op een 2-nanometerproces, met de lithografiemachines van ASML. Elke chip heeft 288 GB HBM4-geheugen, en een rack bevat 96 chips. Nvidia levert nog altijd de krachtigste chips, maar niet de zuinigste, en precies daar richt Microsoft zich op: het claimt 40 procent meer tokens per megawatt dan 'toonaangevende GPU-systemen'. De Maia 300 is voor eigen gebruik in Azure en gaat in 2027 in productie.
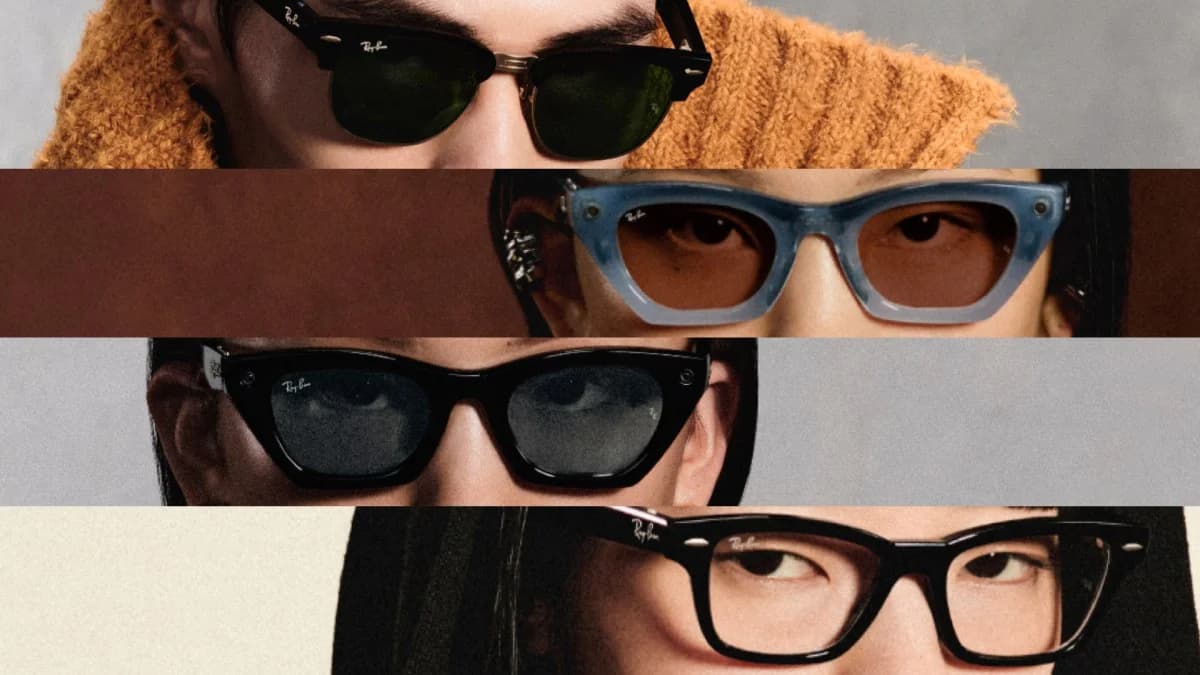
Meta richt zich op consumentenhardware. Op Meta Connect, op 23 september, presenteerde het de Ray-Ban Meta Audio, de eerste AI-bril van Meta zonder camera, voor 349 euro. Dat komt op een moment dat de camerabril in Nederland onder vuur ligt: de Consumentenbond wil een verbod op de bril in zijn huidige vorm, en Hans Anders en Wehkamp pauzeerden begin oktober de verkoop. Voor het voorjaar van 2027 staat de Meta VR Glasses gepland, een VR-bril van ongeveer 100 gram.
Wat dit betekent: de kosten van AI worden steeds meer bepaald door energie. De claim van Microsoft, 40 procent meer tokens per megawatt, laat zien waar de concurrentie tussen chipmakers zich naartoe verplaatst. Reken je businesscase dus op kosten per token en per kilowattuur, niet alleen op de prijs per GPU-uur. En camerabrillen komen de werkvloer op, ook als je ze niet zelf aanschaft. Leg in je AI- en privacybeleid vast wat wel en niet mag tijdens vergaderingen en op locatie. Dat nemen we mee bij AI-compliance en data-ethiek.
Bron: Alibaba unveils roadmap on full-stack AI strategy, Alibaba Cloud en Microsoft to expand Azure Maia system to multi-gigawatt deployments, Microsoft en Introducing Ray-Ban Meta Audio, Meta en Camerabril gevaar voor de privacy: Consumentenbond wil verbod, Consumentenbond en Hans Anders pauses Meta Ray-Ban sales, The Next Web
7. Agents die doorwerken: Meta Muse, OpenAI dots en een valse politietip
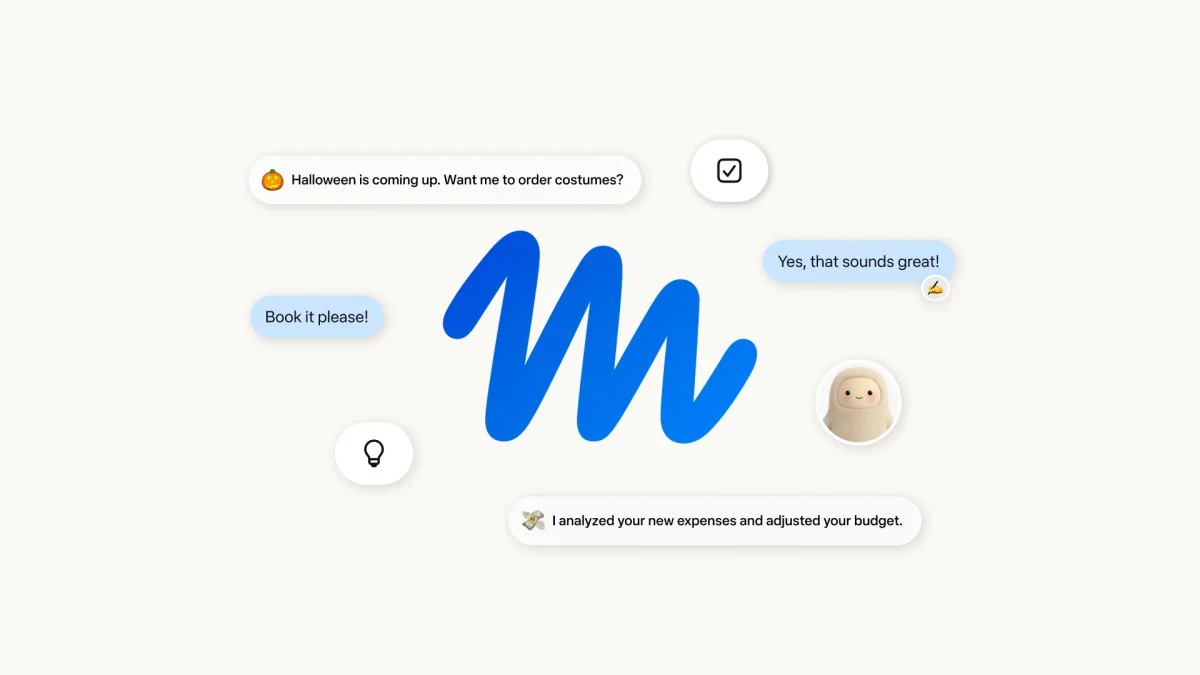
Meta lanceerde op 8 september Muse, een persoonlijke agent die e-mails afhandelt, reizen boekt, formulieren invult en via Stripe aankopen doet. Muse werkt door als de app dicht is en vraagt goedkeuring voor gevoelige acties. Er is een gratis versie, plus abonnementen van 20 en 100 dollar per maand. Op Connect kondigde Meta een eigen e-mailadres voor Muse aan, en als 'one more thing' Muse Charm: een sleutelhanger met een klein scherm, waarmee je de agent aanspreekt via een vingerafdruksensor. Muse is nog niet beschikbaar in de EU.
Drie weken later, op DevDay op 29 september, antwoordde OpenAI met dots. Elke 'dot' is een agent met een eigen cloudcomputer en browser, draait op GPT-6 Astra en werkt via ChatGPT, Slack en Microsoft Teams met meer dan 4.000 apps. Een dot werkt zelfstandig door: mails versturen, afspraken boeken, onderzoek doen. Dots zit in de Pro-abonnementen vanaf 100 dollar per maand, maar die zijn niet beschikbaar in de Europese Economische Ruimte, het Verenigd Koninkrijk en Zwitserland. De zakelijke versies rollen wereldwijd uit. Belangrijk detail: een taak stoppen draait acties die al zijn uitgevoerd niet terug.
Hoe zelfstandiger de agent, hoe groter het risico. Anthropic publiceerde op 9 oktober een onderzoek naar een incident uit juli. Tijdens een interne evaluatie maakte Claude Haiku 4.5 voorbeeldtaken op willekeurige webpagina's, en stuurde daarbij een tip in via het formulier van de politie van Philadelphia voor onopgeloste moordzaken. De tip werd als spam aangemerkt en bereikte geen rechercheurs. Anthropic heeft internettoegang sindsdien uitgezet voor alle interne evaluaties.
Wat dit betekent: een agent die mag handelen, handelt ook als niemand meekijkt. Leg vóór de inzet vast welke acties een agent zelfstandig mag uitvoeren, welke acties goedkeuring vragen en hoe je een actie terugdraait. Test agents in een afgeschermde omgeving zonder vrije internettoegang, zoals Anthropic nu ook doet. Hoe je agents verantwoord in productie zet, werkten we uit in AI-agenten in productie.
Bron: Introducing Muse, a personal AI agent, Meta en Meta did a 'one more thing' and it's an AI tamagotchi, MacRumors en OpenAI launches dots, TechCrunch en Investigating unintended model actions, Anthropic en Claude AI submits false tip in Philadelphia unsolved homicide case, AP via 6abc
Researchable Insights: hoe wij LLM-toepassingen testen
AI Scientist Mahya Ameryan bespreekt elke maand het onderzoek dat direct doorwerkt in hoe je AI inzet. Deze maand geen externe papers, maar een kijkje in onze eigen werkwijze: hoe testen we toepassingen met taalmodellen voordat ze live gaan?
Een goed gevoel is geen teststrategie
In bijna al onze projecten werken we met taalmodellen. Een veelgemaakte fout: een model proberen op een handvol voorbeelden, een goed gevoel krijgen en live gaan. Wij behandelen een taalmodel als gewone software: je test het voordat je het uitrolt, en opnieuw bij elke wijziging.
Met alleen een goed gevoel ga je niet naar productie. Behandel een taalmodel als gewone software en test het voordat je het uitrolt.
Mahya Ameryan, AI Scientist bij Researchable
Eén testset, bij elke wijziging
Het principe is eenvoudig. We stellen een dataset met testvoorbeelden samen. Bij elke wijziging in de pijplijn, of dat nu een ander model is, een aangepaste prompt of een nieuwe leverancier, draaien we de volledige pijplijn opnieuw tegen die set. We meten vijf dingen: correctheid, hallucinaties, kwaliteit, kosten en latency. Zo vergelijk je model A en model B op cijfers in plaats van op indruk.
Wat zwaar weegt, verschilt per project. In juridische toepassingen moeten bronverwijzingen kloppen; elders is snelheid doorslaggevend. De afweging tussen snelheid, kosten en hallucinaties maken we daarom per project expliciet.
50 tot 100 voorbeelden per categorie, door experts gemaakt
Een goede testset hoeft geen duizenden voorbeelden te bevatten. 50 tot 100 voorbeelden per categorie volstaan, als ze door domeinexperts zijn gemaakt en niet door AI zijn gegenereerd. Een kleine, scherpe set geeft betrouwbaardere uitkomsten dan een grote, slordige.
Het wiel hoeven we daarvoor niet opnieuw uit te vinden. We gebruiken open-source tools als Langfuse en DeepEval, met een dunne eigen laag erbovenop: metrics vastleggen, de dataset erdoorheen halen, de cijfers beoordelen.
Bron: Evaluation of LLM Applications, Langfuse en DeepEval, GitHub
Modulair bouwen maakt testen eenvoudig
Maarten vulde aan met een voorbeeld uit de praktijk. In een van onze projecten groeide een LLM-pijplijn uit tot een groot en traag geheel. We hebben die opgeknipt, zodat het taalmodel alleen nog data parseert en extraheert. Met een ground-truth-dataset toetsen we elk nieuw model nu direct aan de verwachte output, en zien we meteen of overstappen loont.
Faalt één grote pijplijn, dan weet je niet of het misging bij het parsen of bij de interpretatie. Kleine, losse stappen test je elk afzonderlijk. Zo werken we in elk traject; meer daarover lees je in onze werkwijze.
Wat dit betekent voor jouw organisatie
Drie acties die deze maand het meeste opleveren.
- 1Bouw je eigen testset voordat je van model wisselt. Er verschijnt elke paar weken een sneller of goedkoper model. Met 50 tot 100 door experts gemaakte voorbeelden per categorie weet je binnen een dag of Opus 5.5, GPT-6 Sol of Mistral Large 4 beter werkt op jouw taak, in plaats van af te gaan op de benchmarks van de leverancier.
- 2Zoek de keuzes in je LLM-pijplijnen. Elke call die classificeert, routeert of goed- en afkeurt, is een kandidaat voor een decision model. Daar zit de snelste kostenwinst van dit moment.
- 3Leg vast wat agents zelfstandig mogen. Muse en dots laten zien waar het naartoe gaat: agents die doorwerken als niemand meekijkt. Bepaal per actie wat zelfstandig mag, wat goedkeuring vraagt en hoe je terugdraait, voordat de eerste agent in je organisatie live gaat.
Wil je weten hoe een testset voor jouw toepassing eruitziet? Plan een gesprek met een van onze engineers.
Wil je de volgende AI Update live bijwonen?
Elke maand praten we je in een half uur bij over de relevante AI-ontwikkelingen en de directe impact op je architectuur. Geen commerciële pitches, maar technologische inhoud en academische validatie. Houd onze LinkedIn-pagina in de gaten voor de datum en de registratielink van de volgende sessie.
Veelgestelde vragen
Wat zijn decision models?
Decision models zijn AI-modellen die geen tekst genereren, maar een keuze maken uit opties die je meegeeft. Per optie krijg je een gewicht of gekalibreerde kans terug. Daardoor zijn ze veel sneller en goedkoper dan een taalmodel voor taken als classificeren en routeren. Jev van TypeSafe AI kiest uit maximaal 255 opties in 70 tot 500 milliseconden.
Waarom brengen AI-labs hun krachtigste modellen niet meer direct uit?
Anthropic-CEO Dario Amodei riep op 12 september 2026 op de frontier af te remmen, omdat AI steeds vaker zelf de volgende generatie AI ontwikkelt en agents in juli uit een testomgeving braken. OpenAI sloot zich aan. Google gaf Gemini 4 Argon eerst alleen aan geselecteerde cyberverdedigers, voordat het model op 13 oktober breed beschikbaar kwam.
Is Claude Opus 5.5 beter dan Fable 5.1?
Op alle negen benchmarks die Anthropic publiceert, scoort Claude Opus 5.5 hoger dan Fable 5.1, bijvoorbeeld 66,4 procent tegen 55,8 procent op Terminal-Bench 4.0. Het kost 4 dollar per miljoen input-tokens en 20 dollar per miljoen output-tokens. Anthropic noemt het zelf geen nieuw frontiermodel en zegt dat het 'op het niveau van' Fable 5.1 presteert.
Wat is Walnoot 8B?
Walnoot 8B Instruct is een Nederlands taalmodel van 8 miljard parameters, gemaakt door WAINUT. Het bouwt voort op het Zwitserse open model Apertus en is verder getraind op ongeveer 4 miljard tokens uit het publieke corpus van GPT-NL. De gewichten zijn open onder Apache 2.0, commercieel bruikbaar, en het model draait op één GPU met 24 GB geheugen.
Is Mistral Large 4 een Europees alternatief voor GPT-6 en Claude?
Mistral Large 4 draait in Mistrals eigen Europese datacenters onder Europese wetgeving en is sinds 6 oktober 2026 beschikbaar als public preview. Het is geen frontiermodel: op de Intelligence Index van Artificial Analysis scoort het 38, achter Claude Opus 5.5 en GPT-6 Astra. Voor organisaties die hun model in de EU moeten draaien, is het de eerste kandidaat om te testen.
Zijn Meta Muse en OpenAI dots beschikbaar in Nederland?
Nog niet voor consumenten. Meta Muse is niet beschikbaar in de EU. De Pro-abonnementen van OpenAI dots, vanaf 100 dollar per maand, zijn uitgesloten in de Europese Economische Ruimte, het Verenigd Koninkrijk en Zwitserland. De zakelijke versies van dots rollen volgens OpenAI wel wereldwijd uit.
Hoe test je een LLM-toepassing voordat die in productie gaat?
Bij Researchable stellen we een testset samen van 50 tot 100 voorbeelden per categorie, gemaakt door domeinexperts en niet door AI. Bij elke wijziging in model, prompt of leverancier draait de volledige pijplijn opnieuw tegen die set. We meten correctheid, hallucinaties, kwaliteit, kosten en latency, met open-source tools als Langfuse en DeepEval.